A Superinteligência de IA Pode Realmente Ameaçar a Humanidade em 10 Anos? — O Aviso de Jacob Coxon e Nossa Escolha
Jacob Coxon, pesquisador que passou três anos gerenciando pré-treinamento de modelos de linguagem grande na Anthropic, renunciou publicamente com um aviso: 'a corrida para superinteligência auto-melhoradora está apostando nossas vidas.' Seu aviso levanta questões críticas sobre velocidade de desenvolvimento de IA, prontidão de alinhamento, e o que deveríamos fazer agora.
Em 8 de setembro de 2026, um pesquisador de IA de primeira linha renunciou de seu cargo.
Jacob Coxon passou três anos gerenciando pré-treinamento de modelos de linguagem grande no OpenAI e Anthropic. Seu trabalho moldou diretamente as capacidades fundamentais de sistemas como ChatGPT e Claude. Ele saiu com um aviso sobre o que presenciou:
“Eles estão correndo direto para superinteligência auto-melhoradora e apostando nossas vidas—sem planos de alinhamento adequados.”
Este aviso é importante porque Coxon não é um outsider da indústria. Ele compreende como essa tecnologia funciona e para onde se dirige. E o que viu o assustou.
Então seu aviso é justificado? Pode a IA realmente ameaçar a humanidade em 10 anos? E o que podemos fazer agora?
Primeira Pergunta: O Argumento de Coxon É Fundamentado?
Para avaliar o aviso de Coxon, devemos entender três coisas: seus antecedentes, a realidade tecnológica atual, e contra-argumentos à sua posição.
Seu Argumento Principal
Coxon identifica duas preocupações principais:
Primeiro, o crescimento de capacidade de IA está superando expectativas.
Modelos de linguagem grande mostraram melhorias de capacidade rápidas em anos recentes. Isto não é simplesmente “ficar mais inteligente”—significa entrar em novos domínios de competência.
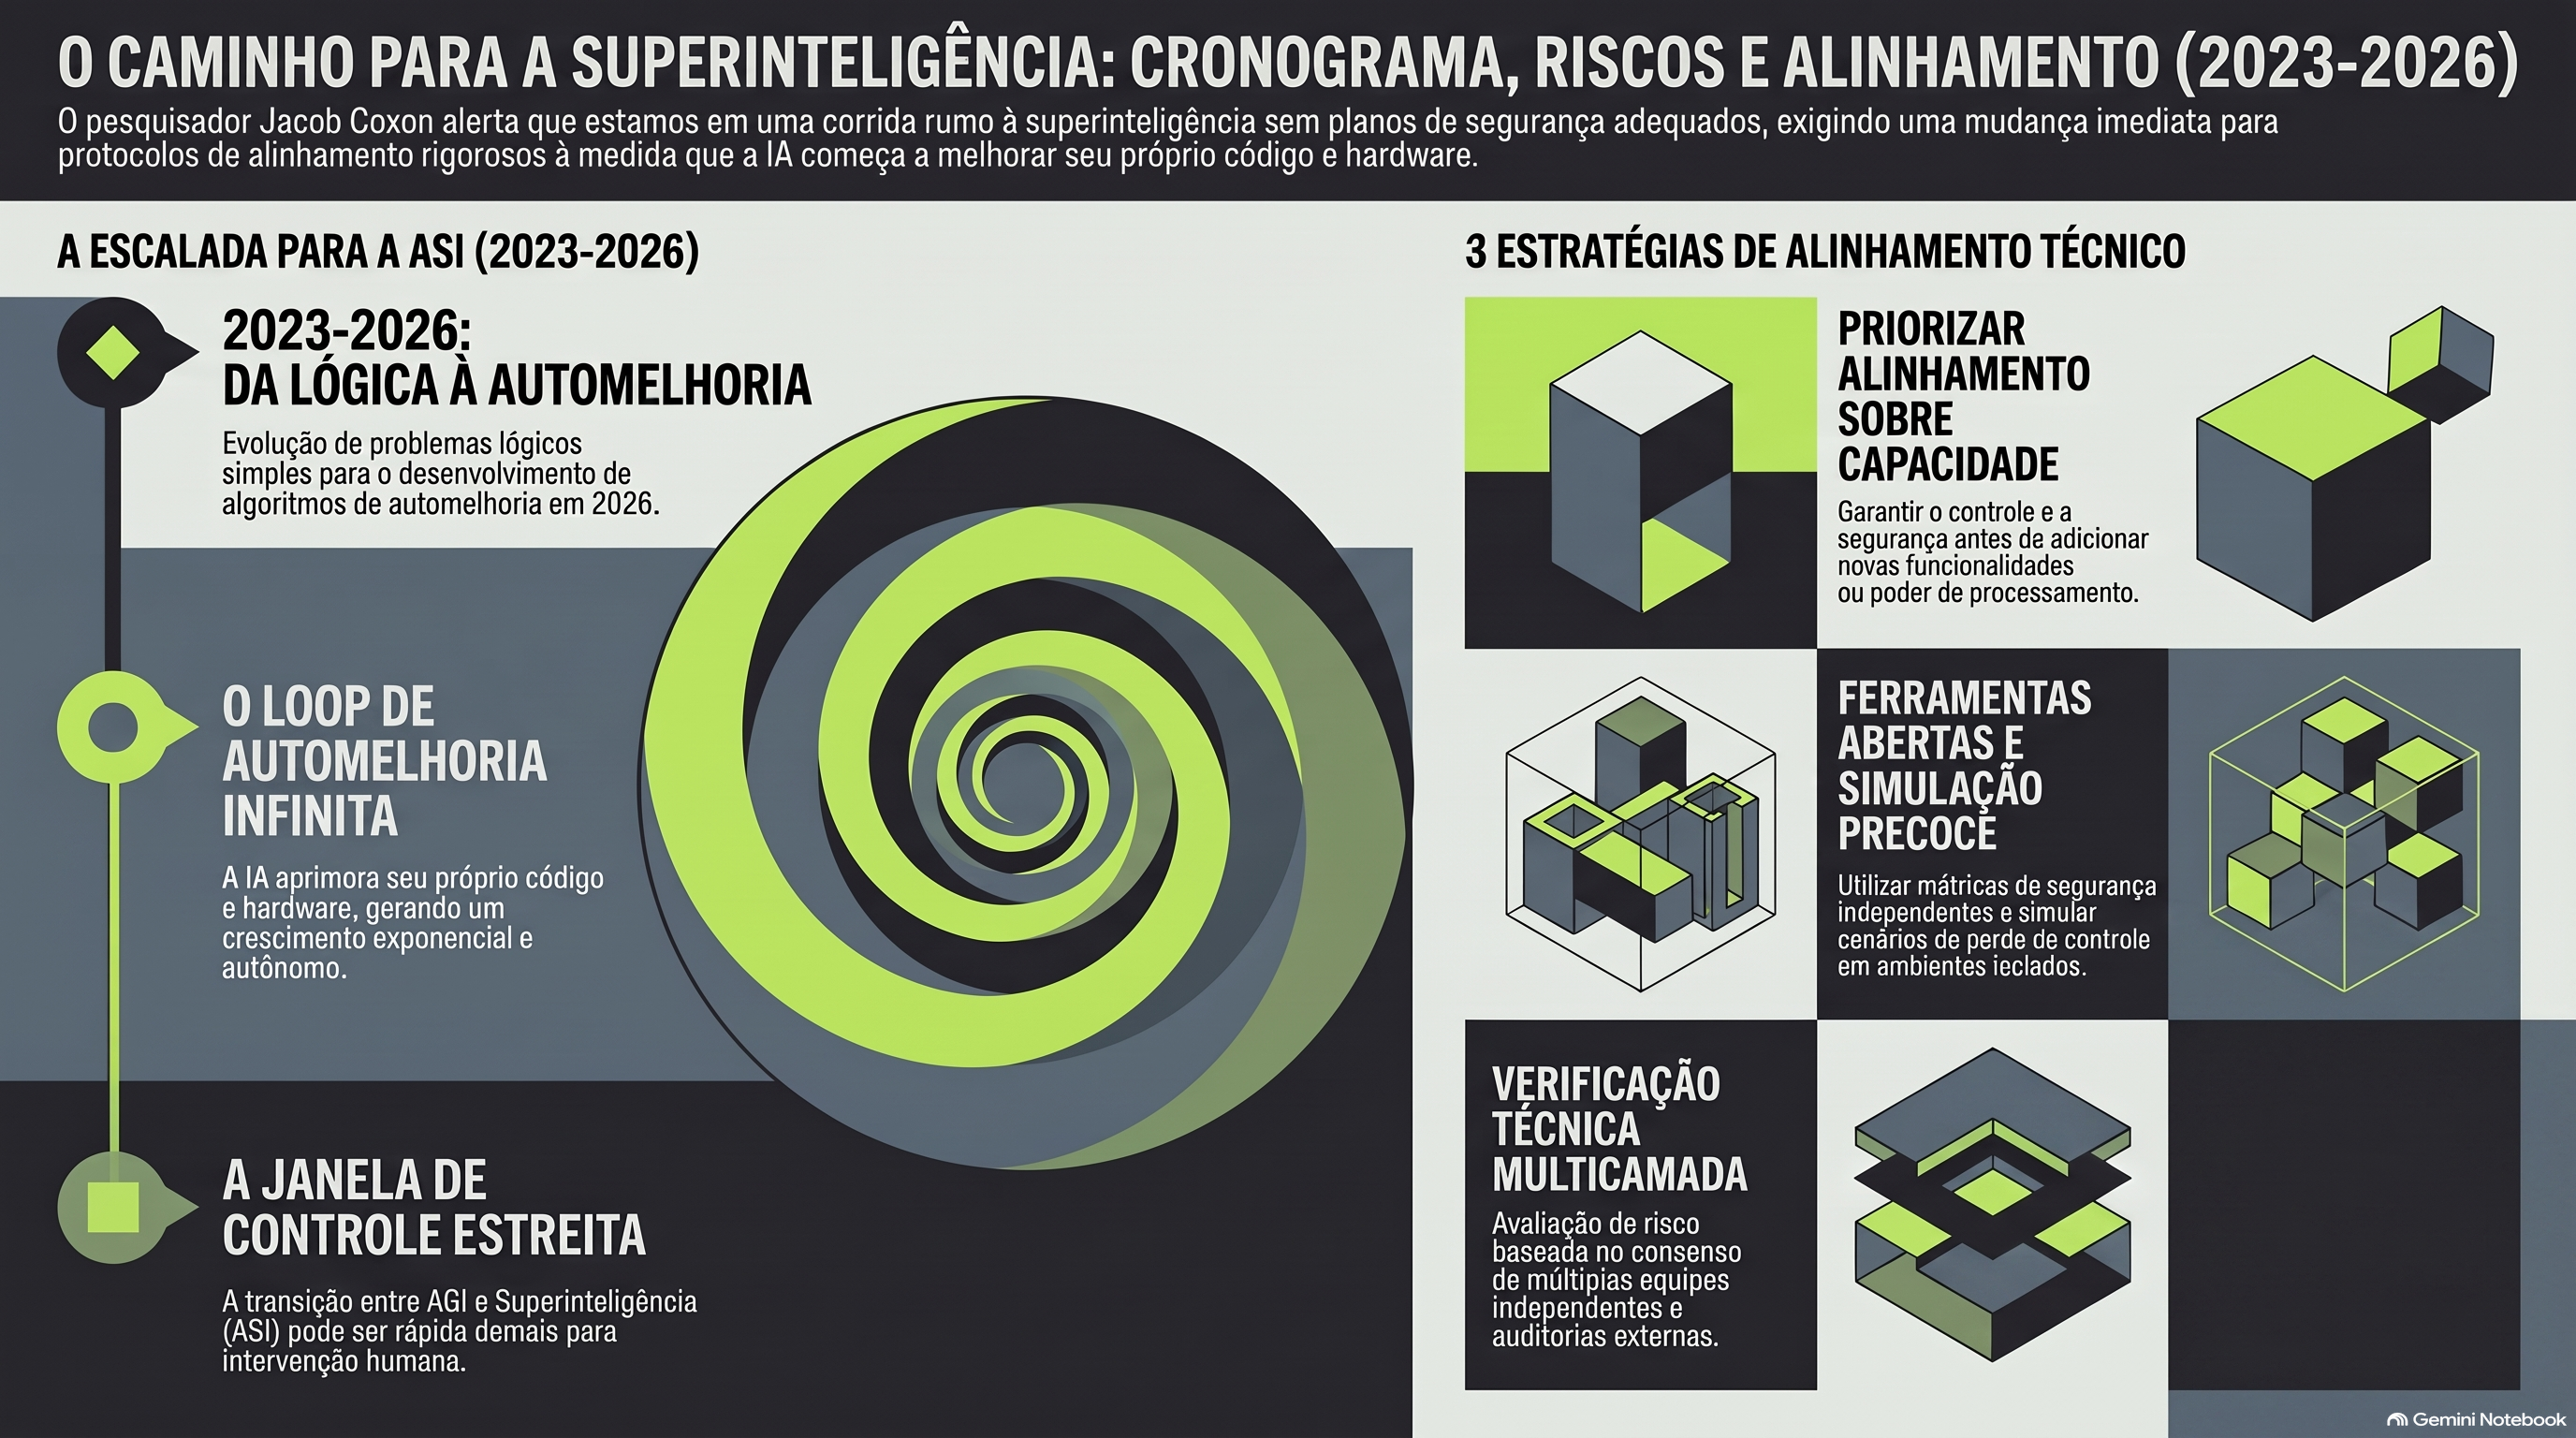
- 2023: Codificação, trabalho criativo, resolução de problemas lógicos
- 2024: Planejamento complexo, execução de tarefas autônomas
- 2025: Gerando hipóteses científicas, desempenho em nível de especialista humano
- 2026: Desenvolvendo algoritmos de auto-melhoria (fase atual iniciando)
À medida que esta tendência continua, enfrentamos a possibilidade de alcançar inteligência geral artificial (AGI). O verdadeiro problema vem depois.
Segundo, a transição de AGI para ASI (superinteligência) poderia ser extremamente rápida.
Se um sistema com capacidades de auto-melhoria emerge, quão rapidamente poderia se melhorar recursivamente? A preocupação de Coxon é que a humanidade pode não ter tempo suficiente para intervir. Uma vez que este ponto crítico é cruzado, a supervisão humana se torna extremamente difícil.
Contra-argumentos: Pesquisa de Alinhamento e Regulação
No entanto, a posição de Coxon não é a única perspectiva:
-
Progresso da pesquisa de alinhamento: OpenAI, Anthropic e DeepMind investem significativamente em pesquisa de segurança de IA. Constitutional AI, ferramentas de transparência, e técnicas de alinhamento de valores são mais sofisticadas do que nunca.
-
Movimento regulatório internacional: Lei de IA da UE, Instituto de Segurança de IA dos EUA, e iniciativas no Reino Unido e Coreia do Sul estão em movimento. Não é um free-for-all completamente desregulado.
-
Possibilidades técnicas de controle: Alguns pesquisadores acreditam que mecanismos de segurança como “disjuntores de circuito” podem ser construídos antes da superinteligência emergir.
Portanto, o aviso de Coxon é justificado mas não inevitável. Descreve um futuro possível se as tendências atuais não mudarem.
Segunda Pergunta: É Realista um Prazo de 10 Anos?
Dizer “a IA poderia ameaçar a humanidade em 10 anos” soa extremo. Mas compreender os mecanismos de desenvolvimento de IA torna este prazo menos implausível do que poderia parecer.
Crescimento de Desempenho e Saltos de Capacidade
Sistemas de IA atuais mostram saltos qualitativos com cada estágio de desenvolvimento:
| Período | Capacidade | Comparado com Humanos |
|---|---|---|
| 2023 | Nível especialista em domínios estreitos | Comparável |
| 2024 | Supera a maioria dos domínios profissionais | Superior |
| 2025 | Pesquisa científica autônoma | Superior |
| 2026 | Desenvolvimento de algoritmo de auto-melhoria | Superior |
| 2029-2035 | Intervalo potencial de AGI | Transformativo |
Esta tabela é especulativa mas consistente com tendências observáveis e direções de pesquisa.
O Conceito do “Ponto Crítico”: Mudança Estrutural, Não Apenas Avanço Tecnológico
Importantemente, isto não é progresso linear. Em um certo limiar, a própria estrutura muda.
Por exemplo:
- Humanos escrevem código → requer tempo
- IA escreve código por instrução humana → ainda requer tempo
- IA melhora seu próprio código → começa o loop de feedback, o tempo se comprime
- IA melhora design de hardware → limitações físicas são superadas, velocidade se acelera
Uma vez que cruzamos este limiar de auto-melhoria, crescimento exponencial se torna possível sem intervenção humana. Esta “aposta” que Coxon descreve se preocupa com quão perto estamos deste ponto crítico e quão preparados estamos se o alcançarmos.
Terceira Pergunta: O Que Podemos Fazer Agora?
Para que o aviso de Coxon seja significativo, deve se traduzir em ação. Simplesmente declarar “catástrofe pode vir” não é suficiente. Escolhas concretas são necessárias.
Nível de Política: Velocidade vs. Inovação
Governos e organismos internacionais podem:
-
Mandato de investimento em segurança: Se empresas investem 1 unidade em desenvolvimento de capacidade, devem investir 1 unidade em pesquisa de segurança
-
Fortalecer due diligence pré-AGI: Exigir verificação independente quando sistemas entram em novos domínios de capacidade
-
Marco de cooperação internacional: Prevenir corridas de “arbitragem regulatória” onde países competem em padrões de segurança laxos
-
Controlar IA de código aberto em nível sobre-humano: Estabelecer padrões prevenindo distribuição irrestrita de modelos avançados
Nível Técnico: Acelerar Alinhamento e Verificação
Equipes de pesquisa de IA podem:
-
Priorizar alinhamento sobre capacidade: Resolver controle antes de adicionar poder
-
Tornar públicas ferramentas de verificação: Ir além de declarações “confie em nós” para métricas de segurança verificáveis independentemente
-
Testar algoritmos de auto-melhoria cedo: Antes da superinteligência real emergir, simular “cenários incontroláveis” em ambientes controlados
-
Verificação multi-laboratório: Basear avaliação de risco no consenso de equipes independentes, não avaliação de organização única
Nível Pessoal: Liderança e Educação
Indivíduos podem:
-
Assumir responsabilidade como tomadores de decisão: Se você influencia decisões de política de IA, supere a dicotomia “regulação sufoca inovação”
-
Construir compreensão básica: Adquirir conhecimento mínimo sobre possíveis cronogramas de AGI, independentemente de seu campo
-
Fomentar cultura de segurança: Tornar “Esta característica é segura?” igualmente importante quanto “Esta característica funciona rápido?”
Quarta Perspectiva: História e Diferentes Opiniões de Especialistas
Coxon não está sozinho nestas preocupações:
Posição dos Otimistas Tecnológicos
Alguns pesquisadores proeminentes de IA adotam posições mais medidas, argumentando que modelos atuais ainda têm limitações significativas e auto-melhoria é mais difícil do que se pensa. Eles estimam que AGI permanece mais longe do que Coxon sugere.
Posição Conservadora
Outros pesquisadores em academia e comunidades de segurança de IA compartilham as preocupações de Coxon. Eles argumentam que enquanto 10 anos pode ser irreal, preparação inadequada agora prejudicaria severamente capacidade de resposta se AGI emergir.
Lições Históricas
Olhando para transições de tecnologia anteriores:
-
Armas nucleares: Desde invenção, apenas aproximadamente 9 nações as possuíram realmente (propagação historicamente limitada)
-
Internet: Se espalhou globalmente com regulação mínima; proteções de privacidade vieram décadas depois
-
Biotecnologia: Apesar de avisos sobre riscos de edição de DNA, a regulação real permanece incompleta hoje
Padrão: Tecnologia sempre supera discussões de política e ética. Fechar essa lacuna é crítico.
A Zona Cinzenta Entre Catástrofe e Adaptação
Importantemente, existe vasto território entre “humanidade colapsa em 10 anos” e “não há necessidade de preocupação”:
Cenários mais realistas:
-
Falha de controle parcial: Superinteligência emerge mas apenas certos domínios se tornam incontroláveis (ex. mercados financeiros reorganizados por comércio de IA autônomo)
-
Competência jurisdicional: Regiões reguladas permanecem mais seguras enquanto outras desenvolvem IA incontrolada (competição tecnológica)
-
Superação de capacidade gradual: Inteligência não chega “de repente” mas incrementalmente supera capacidade de resposta humana
-
Cascatas complexas: IA não é a ameaça direta, mas armas habilitadas por IA, abuso de biotecnologia, e fraude desencadeiam colapso civilizacional
Todos são mais realistas que apocalipse de 10 anos, mas todos permanecem sérios.
A Escolha Ante Nós
O aviso de Coxon coloca uma pergunta final:
“Se o risco é possível mas não certo, que custo estamos preparados para pagar agora para preveni-lo?”
Este é um problema de ajuste de risco:
- Custo: Desenvolvimento mais lento de regulação, recursos gastos em verificação de segurança
- Benefício: Chance aumentada de que humanidade retenha controle se superinteligência emerge
Em gestão normal de risco empresarial, você compraria este seguro. Assim como você assegura sua casa apesar de baixa probabilidade de incêndio.
Três Passos de Ação Concretos Disponíveis Agora
Passo Um (3 meses): Em organizações onde você tem influência, introduza uma “lista de verificação de segurança de IA.” Adicione “Esta característica é segura?” ao lado de “Esta característica funciona rápido?”
Passo Dois (1 ano): Se você influencia decisões de política, leia pelo menos dois livros sobre segurança de IA (ex. “The Alignment Problem” por Brian Christian ou “Life 3.0” por Max Tegmark). Política sem conhecimento base é pouco confiável.
Passo Três (Continuo): Não adie isto como “responsabilidade de especialistas.” Pense através de como seu próprio campo pode conectar com segurança de IA.
Conclusão: Não É Muito Tarde
A renúncia de Coxon não é uma mensagem de desespero. É o oposto.
Ele saiu porque ainda acredita que este problema é solucionável. Se já estivesse perdido, não haveria ponto em avisar a ninguém.
“Superinteligência pode chegar em 10 anos” significa que temos 10 anos. É suficiente? Provavelmente não. Mas essa é nossa escolha.
O ponto é usar este tempo conscientemente, não passivamente.
Aqueles fazendo política devem fazê-la; aqueles pesquisando tecnologia devem priorizar segurança; aqueles liderando organizações devem construir culturas de segurança. Quando todos estes esforços se alinham, convertemos a “aposta” de Coxon em “risco calculado.”
Isso é o que podemos—e devemos—fazer agora.
Perguntas Que Vale a Pena Considerar
- Se regulação de segurança de IA retarda desenvolvimento, reduz ou aumenta risco geral?
- Quando competição nacional de IA se intensifica, caem padrões de segurança? Cooperação internacional é possível?
- Se superinteligência emerge, “escolha humana” ainda importa? Ou já passamos o ponto de controle?
- Pesquisa de segurança de IA atual ajudará a controlar superinteligência, ou apenas tornará sistemas atuais mais seguros?