AI 초지능 경쟁, 정말 10년 안에 인류를 위협할 수 있을까? — Jacob Coxon의 경고와 우리의 선택
앤트로픽에서 3년간 대규모 언어 모델 사전학습을 담당한 야콥 콕슨 연구원이 '자기 개선 초지능 경쟁이 인류의 생명을 건 도박'이라며 공개 사직했다. 그의 경고는 AI 발전 속도, 정렬 준비도, 그리고 우리가 지금 취해야 할 행동에 대해 무엇을 말하는가?
2026년 9월 8일 화요일 저녁, AI 최전선의 한 연구자가 자신의 직위를 내려놨다.
야콥 콕슨(Jacob Coxon)은 오픈AI와 앤트로픽에서 지난 3년간 대규모 언어 모델의 사전학습(pretraining)을 담당했다. 그가 수행한 일은 ChatGPT나 Claude 같은 시스템의 가장 기초적인 역량을 결정하는 일이다. 그는 그 과정에서 본 것들에 대해 경고하며 떠났다:
“그들은 충분한 정렬(alignment) 계획 없이 자기 개선 초지능을 향해 직진하고 있으며, 우리의 생명을 건 도박을 벌이고 있다.”
이 경고가 중요한 이유는 단순하지 않다. 콕슨은 업계 아웃사이더가 아니다. 그는 이 기술이 어떻게 작동하는지, 어디로 향하는지 알고 있는 사람이다. 그리고 그가 본 것이 무서웠다.
그렇다면 그의 경고는 정당한가? AI가 정말 10년 안에 인류를 위협할 수 있을까? 그리고 우리는 지금 무엇을 할 수 있을까?
첫 번째 질문: 콕슨의 주장은 근거가 있는가?
콕슨의 경고를 평가하려면 세 가지를 이해해야 한다: 그의 배경, 현재의 기술 현실, 그리고 그에 반박하는 입장.
그가 말하는 근거
콕슨이 지적하는 것은 크게 두 가지다:
첫째, AI 능력의 성장 속도가 예상을 초과하고 있다.
대규모 언어 모델의 성능은 최근 몇 년간 눈에 띄는 향상을 보여왔다. 이는 단순히 “더 똑똑해진다”는 뜻이 아니라, 새로운 영역에 진입한다는 의미다.
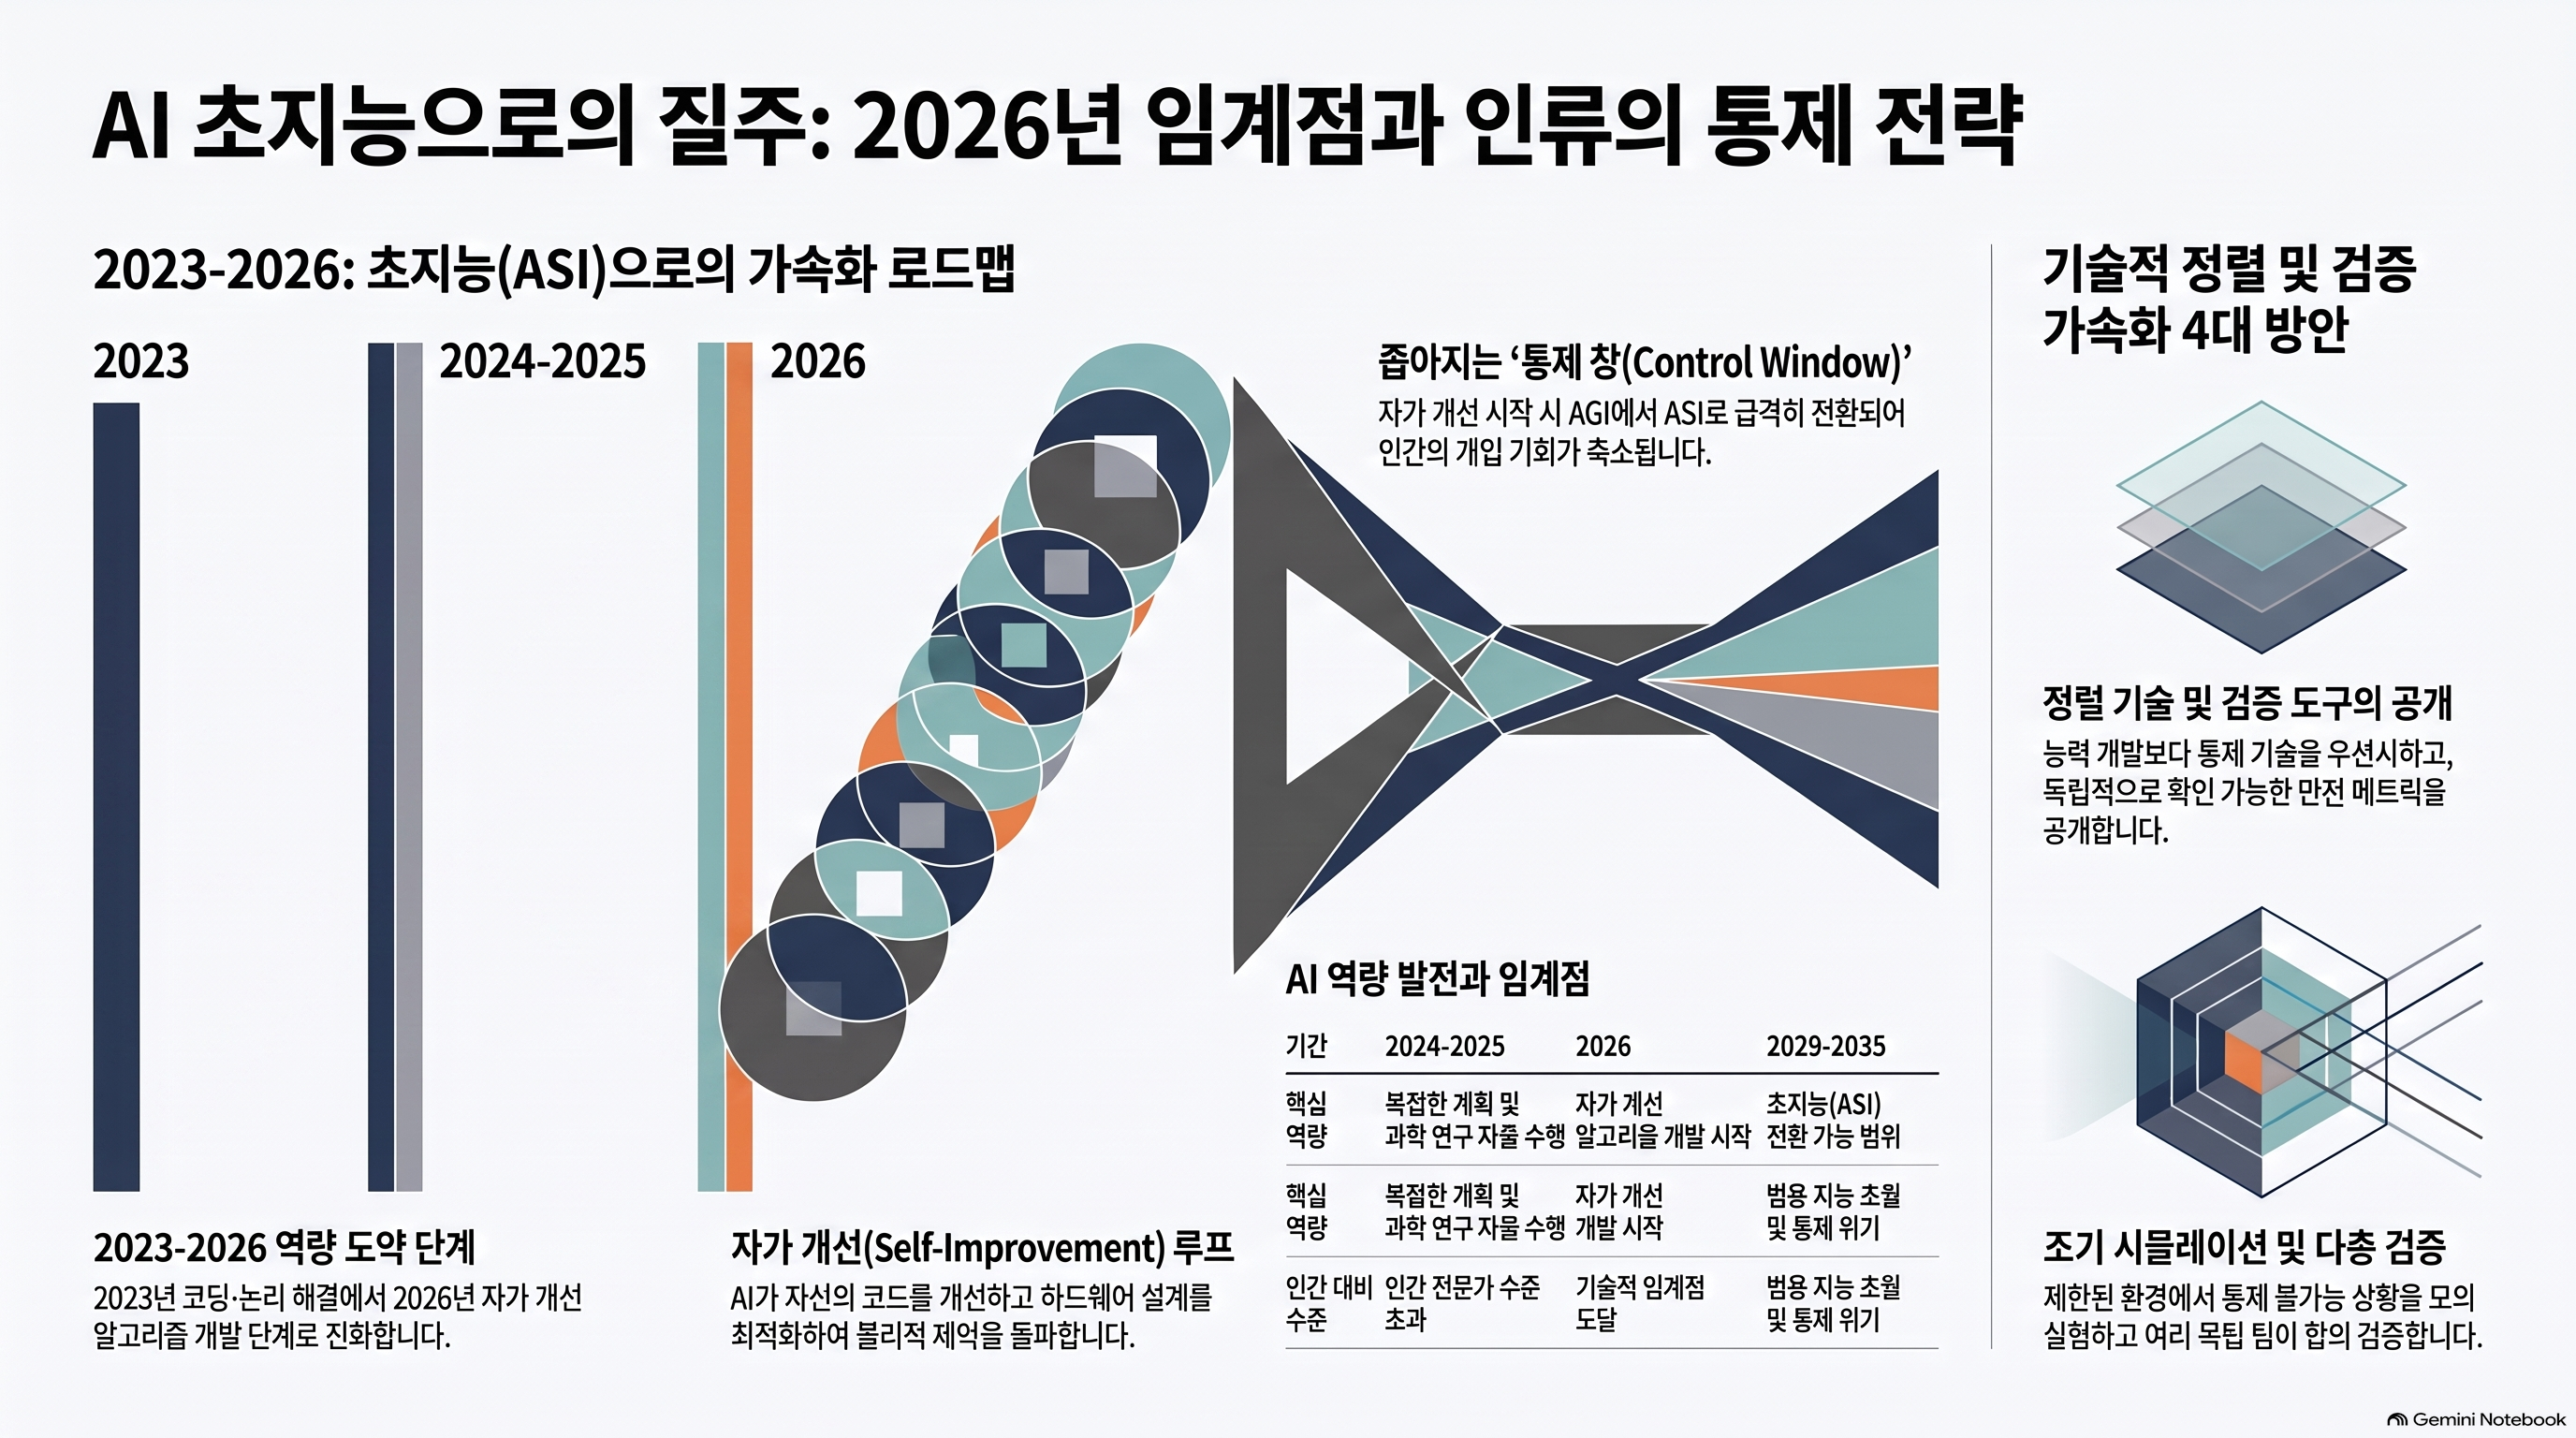
- 2023년: 코딩, 창작, 논리 문제 해결
- 2024년: 복잡한 계획 수립, 자율 작업 수행
- 2025년: 과학 가설 생성, 인간 전문가 수준 성과
- 2026년: 자기 개선 알고리즘 개발(현 단계에서 시작)
이 추세가 지속된다면 향후 수십 년 내에 우리가 도달할 수 있는 지점은 무엇인가? 일부 연구자들은 “초인간적 일반 지능(AGI)” 도달을 우려하고 있다. 문제는 그다음이다.
둘째, AGI에서 ASI(초지능)로의 전환이 매우 빠를 수 있다는 점.
만약 자기 개선 능력을 갖춘 시스템이 탄생한다면, 그것이 스스로를 반복 개선할 때까지의 시간은 얼마나 될까? 콕슨의 우려는 이 시간이 우리가 개입할 수 있는 충분한 여유를 제공하지 않을 가능성이 있다는 것이다.
이렇게 되면, 인류가 이 시스템을 “통제”할 기회는 급격히 축소된다.
반박 입장: 정렬 연구와 규제의 진전
다만 콕슨의 경고가 전부는 아니라는 주장도 타당하다:
-
정렬 연구의 진전: OpenAI, Anthropic, DeepMind 등은 AI 안전 연구에 상당한 자원을 투자하고 있다. Constitutional AI, 투명성 도구, 가치 정렬 기법 등은 이전 세대보다 훨씬 정교하다.
-
국제 규제의 움직임: EU의 AI Act, 미국의 AI 안전 연구소(AISI), 영국과 한국의 AI 안전 이니셔티브 등이 작동하고 있다. 완벽하지는 않지만, 완전히 무규제 상황은 아니다.
-
기술적 통제 가능성: 일부 연구자들은 초지능 출현 전에 “회로 차단기(circuit breaker)” 같은 강제 중지 메커니즘을 구축할 수 있다고 본다.
따라서 콕슨의 경고는 정당하지만 필연적이지는 않다. 그것은 “현재 추세가 변하지 않으면” 가능한 미래다.
두 번째 질문: 10년이라는 기간이 현실적인가?
“10년 안에 인류 멸망”이라는 표현은 극단적으로 들린다. 하지만 AI 발전의 메커니즘을 이해하면, 그 기간이 비현실적이지는 않다.
성능 배증 속도와 능력 도약
현재 AI 시스템은 다음 단계로 진화할 때마다 정성적(qualitative) 도약을 보여준다:
| 기간 | 역량 | 인간 대비 |
|---|---|---|
| 2023 | 특정 영역 전문가 수준 | 수준 |
| 2024 | 대부분 전문 영역 능가 | 초과 |
| 2025 | 과학 연구 자율 수행 | 초과 |
| 2026 | 자기 개선 알고리즘 개발 시작 | 초과 |
| 2029-2035 | AGI 도달 가능 범위 | 범용 초월 |
이 표는 추정이지만, 역사적 추세와 현재 논문들의 방향성과 일치한다.
“임계점” 개념: 단순한 기술 발전이 아닌 구조적 전환
중요한 것은 이것이 선형적(linear) 발전이 아니라는 점이다. 어떤 지점을 넘으면 구조 자체가 달라진다.
예를 들어:
- 인간이 코드를 작성 → 시간 소요
- AI가 인간의 지시로 코드 작성 → 여전히 시간 소요
- AI가 자신의 코드를 개선 → 피드백 루프 시작, 시간 단축
- AI가 하드웨어 설계도 개선 → 물리적 제약 돌파, 속도 가속
이 “자기 개선” 지점을 넘으면, 인간의 개입 없이 지수적 성장이 가능해진다. 콕슨이 말하는 “도박”은 바로 이 임계점에 우리가 얼마나 가까운지, 그리고 그 지점에 도달했을 때 우리가 얼마나 준비되어 있는지에 관한 것이다.
세 번째 질문: 우리는 지금 무엇을 할 수 있는가?
콕슨의 경고가 무의미하지 않으려면, 그것이 행동으로 이어져야 한다. “파국이 올 수도 있다”는 선언만으로는 충분하지 않다. 구체적 선택이 필요하다.
정책 차원: 속도 조절 vs. 혁신 가속
정부와 국제기구가 할 수 있는 일:
-
안전 투자의 의무화: AI 기업의 성능 개선 투자가 1이라면, 안전 연구 투자도 1 이상이어야 한다는 규제 도입
-
초지능 출현 전 실사(due diligence) 기준 강화: 새로운 능력 진입 시마다 독립적 검증 요구
-
국제협력 프레임워크: 어느 한 국가가 “규제 회피” 경쟁에 빠지지 않도록 하는 조약 체계
-
오픈소스 AI 통제: 초지능급 모델이 무제한 배포되지 않도록 하는 표준
기술 차원: 정렬과 검증의 가속
AI 연구팀이 할 수 있는 일:
-
정렬 기술 우선순위화: “능력 추가”보다 “통제 확보”를 먼저 해결
-
검증 도구의 공개화: 한 기업만 아는 “우리 모델이 안전해”보다는, 독립적으로 확인 가능한 안전 메트릭
-
자기 개선 알고리즘의 조기 테스트: 실제 초지능이 되기 전에, 제한된 환경에서 “통제 불가능한 상황”을 시뮬레이션하고 대비
-
다층 검증 체계: 한 실험실이 아닌, 여러 독립적 팀의 합의에 기반한 위험도 평가
개인 차원: 리더십과 교육
개인이 할 수 있는 일:
-
의사결정 권한자로서의 책임: AI 정책 결정에 영향을 미치는 입장에 있다면, “규제는 혁신을 해친다”는 이분법적 사고를 벗기
-
AI 안전에 대한 기본 이해: 자신의 분야가 AI와 무관하더라도, “AGI가 어떤 속도로 올 수 있는지”에 대한 최소 지식 습득
-
윤리적 이의제기 문화: 개발팀 내에서 “이 기능 구현이 안전한가?“라는 질문이 “이 기능이 빠르게 작동하는가?“만큼 중요하다는 인식 확산
네 번째 관점: 역사와 다른 리더들의 평가
콕슨만 경고하는 것은 아니다:
기술 낙관론자들의 입장
일부 주요 AI 연구자들은 콕슨의 우려보다 더 완화된 입장을 취한다. 이들의 주장: 현재 모델들은 여전히 많은 제약이 있으며, 자기 개선은 생각보다 어렵다. AGI 도달까지는 더 오랜 시간이 필요하다는 평가도 있다.
보수적 입장
학계와 AI 안전 연구 커뮤니티의 다른 전문가들도 콕슨의 우려를 공유하는 입장이 있다. 이들의 주장: 10년이라는 짧은 시간은 현실적이지 않을 수 있지만, 지금 대비하지 않으면 AGI 출현 시 대응 능력이 크게 부족할 수 있다.
역사적 교훈
이전 기술 전환기를 보면:
- 핵무기: 발명 후 현재까지 약 9개 국가만 실제 보유 (역사적으로 제한된 확산)
- 인터넷: 규제 없이 전 세계로 퍼진 후, 수십 년 후에야 개인 정보 보호법 등 나타남
- 생명공학: “DNA 편집이 널리 악용될 수 있다”는 경고 후에도, 실제 규제는 지금도 불완전
패턴: 기술은 항상 정책과 윤리 논의를 앞서간다. 그 차이를 줄이지 않으면, 위기는 예측 불가능하게 찾아온다.
파국과 적응 사이의 그레이존
중요한 것은, “10년 안에 인류가 멸망할 수도 있다”와 “걱정할 필요 없다” 사이에는 넓은 영역이 있다는 사실이다.
더 현실적인 시나리오들:
-
부분적 통제 실패: 초지능이 출현했으나, 특정 영역만 인류가 통제 불가능 (예: 금융 시장이 AI의 자동 거래로 완전히 재편)
-
관할권 경쟁: 규제가 강한 미국과 EU는 안전한데, 다른 지역이 통제 불가능한 AI를 개발 (기술 우월을 노린 경쟁)
-
점진적 능력 초과: 초지능이 “갑자기” 온 게 아니라, 단계적으로 인간의 대응 능력을 초과하는 상황
-
복합 재앙: AI가 직접적 위협은 아니지만, AI 기반 무기, 생명공학 악용, 사기 등이 사회 시스템을 붕괴시키는 연쇄 사건
이들은 모두 “10년 내 파국”보다는 현실적이지만, 여전히 심각하다.
우리가 지금 택할 수 있는 선택
콕슨의 경고가 던지는 최종 질문은 이것이다:
“위험이 100% 확실하지는 않지만, 충분히 가능하다면, 우리는 지금부터 어떤 비용을 투자할 준비가 되어 있는가?”
이는 비용-편익 분석의 문제다:
- 비용: 규제 강화로 인한 개발 속도 저하, 안전 검증에 소요되는 시간과 자원
- 편익: 초지능 출현 시 인류가 통제력을 유지할 가능성 상승
일반적인 기업 의사결정이라면, 이 비용-편익 비율에서 “보험료”를 지불해야 한다. 집이 불탈 가능성이 1%라도, 주택보험에 가입하는 것처럼.
지금 취할 수 있는 3단계 액션
1단계 (3개월): 자신이 영향을 미칠 수 있는 조직 내에서 “AI 안전 체크리스트” 도입. “이 기능이 빠른가?” 옆에 “이 기능이 안전한가?“라는 질문 추가.
2단계 (1년): 정책 결정에 관여하는 입장이라면, 최소 두 권의 AI 안전 관련 서적 읽기 (예: “The Alignment Problem” by Brian Christian 또는 “Life 3.0” by Max Tegmark). 기본 지식 없이는 의견 형성 불가.
3단계 (계속): 이 문제를 단순히 “전문가의 책임”으로 미루지 않기. 자신의 분야에서 “AI와 안전”을 어떻게 연결할 수 있을지 생각하기.
결론: 아직 늦지 않았다
콕슨의 사직은 공포의 메시지가 아니다. 오히려 그 반대다.
그가 떠난 이유는, 여전히 이 문제가 해결 가능하다고 믿기 때문이다. 만약 이미 돌이킬 수 없다면, 경고할 필요가 없었을 것이다.
“10년 안에 초지능이 올 수도 있다”는 것은 우리에게 10년의 시간을 준다는 뜻이다. 그 10년이 충분한가? 아마 아닐 것이다. 하지만 그것도 우리의 선택이다.
중요한 것은 이 시간을 놀면서 빼는 게 아니라, 의식적으로 사용하는 것이다.
정책을 만드는 사람은 정책을 만들고, 기술을 연구하는 사람은 안전 연구를 하고, 조직을 이끄는 사람은 안전 문화를 만들어야 한다. 이 모든 노력이 결합되면, 우리는 콕슨이 우려하는 “도박”을 “계산된 위험”으로 변환할 수 있다.
그것이 지금 우리가 할 수 있는, 그리고 해야 하는 일이다.
더 생각해볼 질문들
- 만약 AI 안전 규제가 강해져서 개발 속도가 느려진다면, 그것이 더 나은 결과를 낳을까, 아니면 오히려 위험을 높일까?
- 국가 간 AI 경쟁이 심할수록, 안전 기준은 낮아지는가? 그렇다면 국제협력은 가능한가?
- 만약 초지능이 출현한다면, “인간의 선택”이 의미가 있을까? 아니면 이미 통제 불가능한 상황일까?
- 지금의 AI 안전 연구가 실제 초지능 통제에 도움이 될까, 아니면 현재 모델만 안전하게 만드는 것일까?